Openobserve - Instalación
- Monitorización , Openobserve
- July 20, 2026
Table of Contents
En esta serie voy a documentar el despliegue y uso de OpenObserve como plataforma centralizada para la recopilación y análisis de logs dentro de un laboratorio de ciberseguridad. El objetivo no es únicamente mostrar cómo instalarlo, sino entender cómo funciona y por qué puede ser una alternativa muy interesante a soluciones más conocidas.
¿Por qué Openobserve?
Buscaba salir de la zona de confort, obligar a investigar, a entender lógicas de flujo y aprender conceptos en lugar de copiar configuraciones. Y seamos honestos también algunos tokens se han ido por el camino.
El stack ELK (Elastic, Logstash y Kibana) o Grafana Loki son prácticamente un estándar. Eso tiene muchas ventajas: enorme documentación, miles de tutoriales y una comunidad inmensa.
Además es un proyecto open source con licencia Apache 2.0, en constante desarrollo y con una comunidad activa.
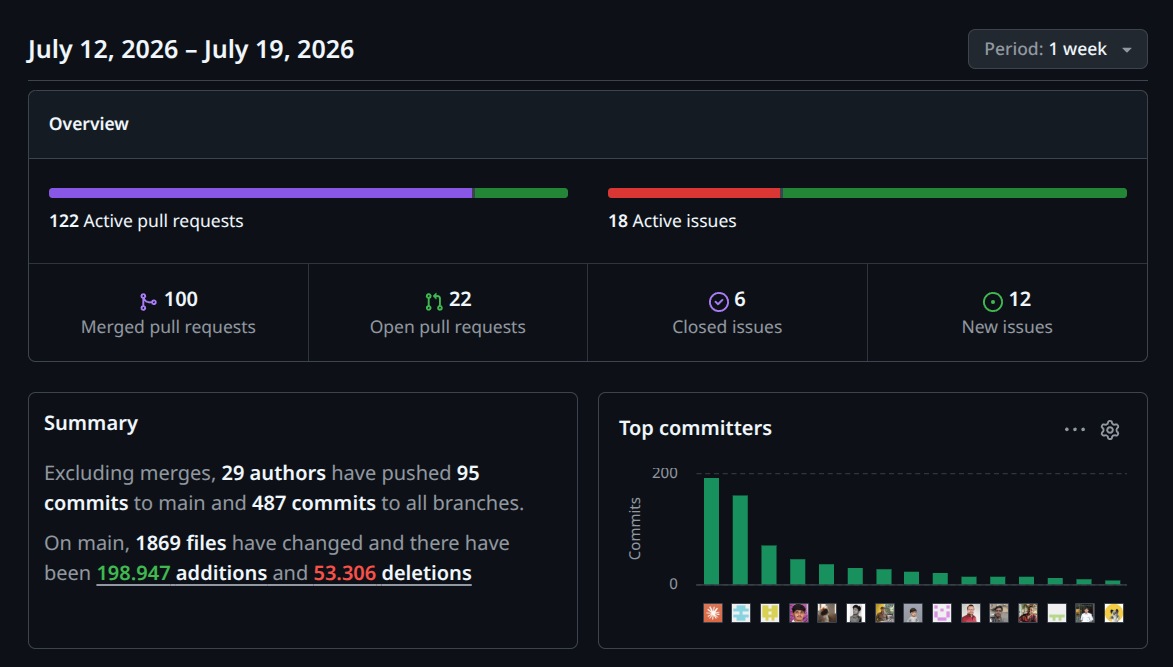
El proyecto se encuentra muy vivo, de hecho para hacer la captura que acompaña a este párrafo al entrar en su Github me acabo de dar cuenta de que hasta Claude está metiendo mano en esta herramienta.
Además cuenta con una arquitectura moderna:
- Escrito en Rust.
- Consumo de RAM reducido.
- Ausencia de garbage collector (menos latencia, menos consumo, mejor aprovechamiento hardware).
- Binario único (nada de Java, Elasticsearch, Logstash…). Esto simplifica Backups, despliegues y actualizaciones.
- Indexación eficiente.
- Compatibilidad con OpenTelemetry.
- Escalable (Localmente, Docker, Kubernetes, Kloud).
Openobserve no es únicamente un visor de logs, también permite:
- logs.
- métricas.
- traces.
- dashboards.
- alertas.
- pipelines.
- funciones.
- búsquedas.
Formas de instalación
Openobserve soporta distintas formas de instalación incluso cloud.
| Instalación | Cuando usar |
|---|---|
| Binario | Muy sencillo |
| Docker | Laboratorios y servidores |
| Kubernetes | Producción |
En mi primer contacto con openobserve lo realicé a través de binario y la verdad que era muy sencillo tanto de instalar(binario + crear servicio en systemd) como actualizarlo.
Pero para esta segunda ocasión he decidido usar docker-compose, el fichero de configuración (similar al binario, sería el siguiente):
  openobserve:
    image: openobserve/openobserve:latest
    container_name: openobserve
    restart: unless-stopped
    ports:
      - "5080:5080"  # <--- Esto mapea el puerto del host al contenedor
    environment:
      ZO_DATA_DIR: /data  # <--- donde almacenar los datos persistentes
      ZO_ROOT_USER_EMAIL: correo.correo@correo.com # <--- el correo de acceso
      ZO_ROOT_USER_PASSWORD: Contraseñafuertequeflipas # <--- contraseña de acceso
    volumes:
      - ./openobserve/data:/data
    networks:
      - proxy
Estos mismos parámetros enviroment son los necesarios en el binario cuando se crea el servicio.
Pues una vez arrancado y funcionando solo queda acceder desde el navegador. Con la ip y el puerto facilitados, donde nos recibirá un panel de login tal que este:
y una vez loggeados nos recibidá un primer panel con información de la infraestructura con datos sobre la ingesta.
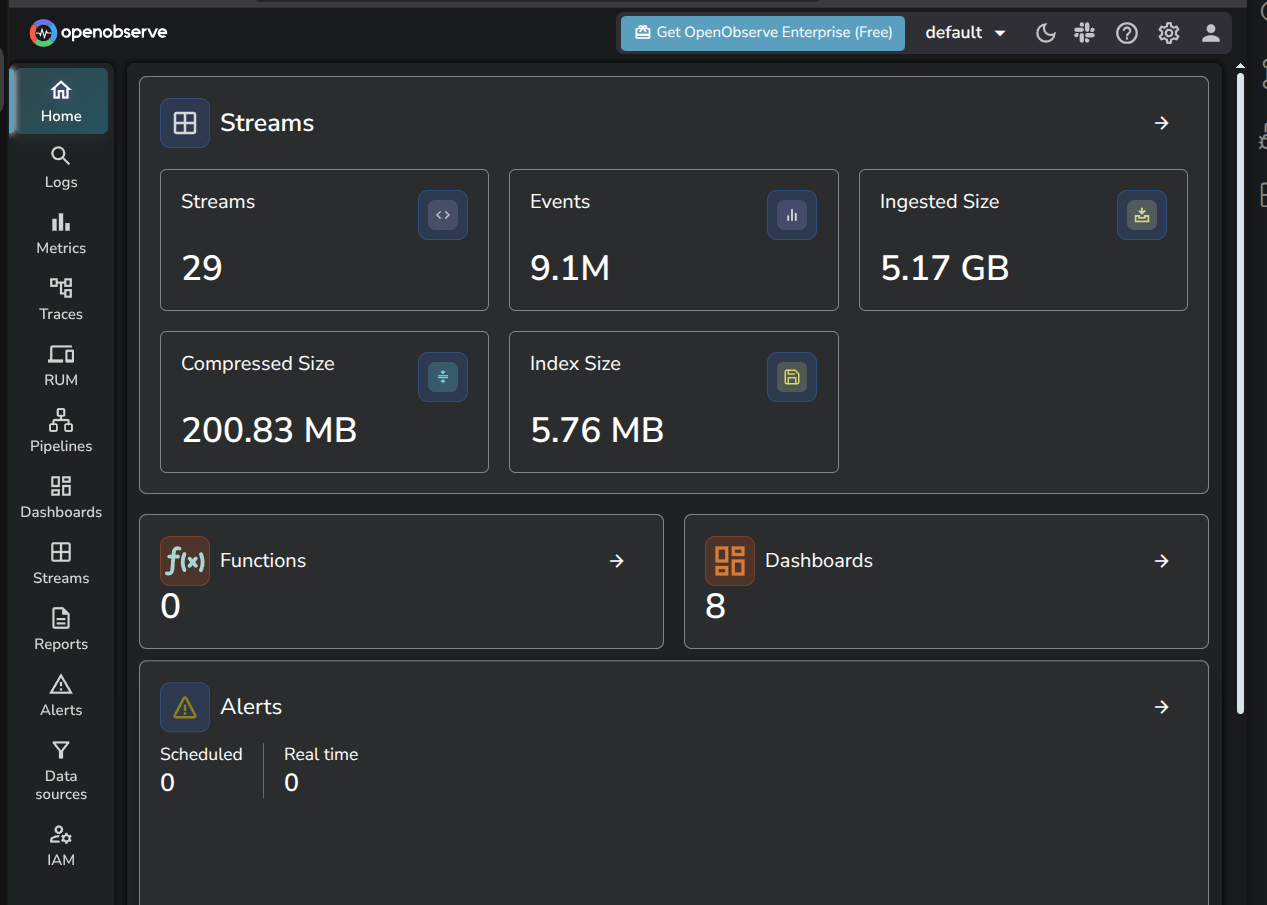
Y en esta primera parte ya podemos ver en la izquierda un menu vertical:
- Home: La imagen que hemos visto antes que nos recibe al iniciar sesión
- Logs: una vez configurada la ingesta de logs, se pueden consultar y buscar en este.
- Métricas: similar a la opción anterior pero esta vez para métricas de recursos hardware.
- Traces: Análisis de trazas distribuidas para seguir el recorrido de una petición entre diferentes servicios.
- RUM (Real User Monitoring): Monitorización de la experiencia real de los usuarios en aplicaciones web, recopilando datos desde el navegador.
- Pipelines: Procesamiento de datos en la ingesta, permitiendo transformar, enriquecer o filtrar la información antes de almacenarla.
- Dashboards: Creación de paneles visuales que agrupan gráficos, tablas y métricas para facilitar la monitorización.
- Streams: Gestión de los flujos de datos almacenados, organizando logs, métricas y trazas por tipo o fuente.
- Reports: Generación y programación de informes basados en consultas o dashboards para su distribución periódica.
- Alerts: Configuración de reglas que generan notificaciones automáticas cuando se cumplen determinadas condiciones.
- Data sources: Administración de las fuentes de datos y conexiones utilizadas por OpenObserve.
- IAM: Gestión de usuarios, roles y permisos para controlar el acceso a la plataforma.
Bonus track
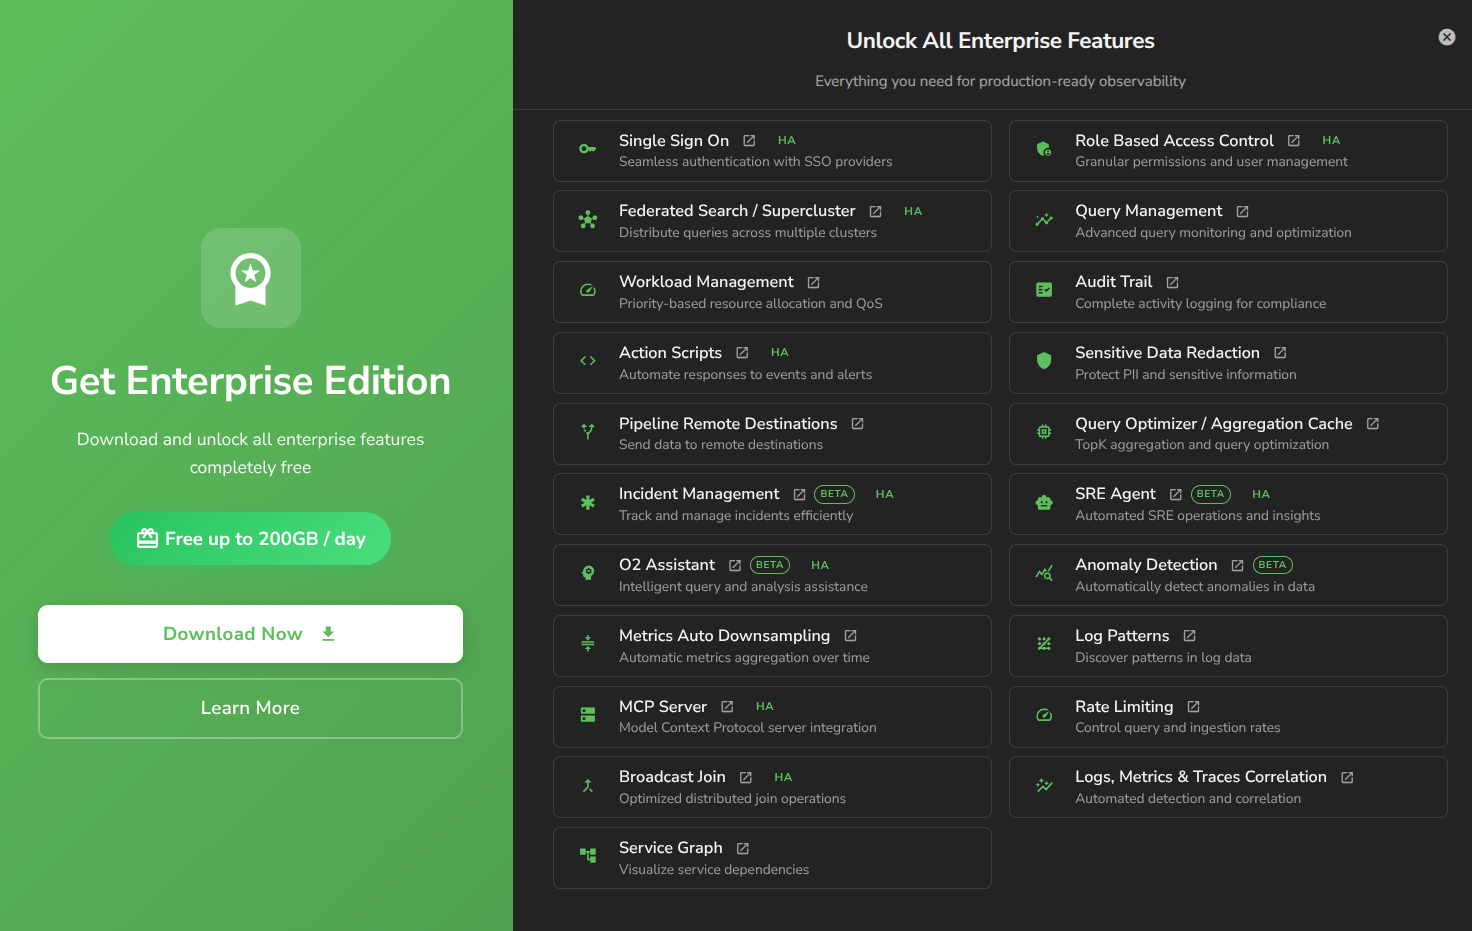
También tiene una versión “enterprise” que es gratuita hasta cierta capacidad de almacenamiento(200GB) que ofrece distintas funciones bastante interesantes. Esto es algo que tengo intención de explorar más adelante.