Openobserve - Ingesta de logs
- Monitorización , Openobserve
- July 25, 2026
Table of Contents
Ingesta de datos en OpenObserve: del origen al almacenamiento
Una vez desplegado OpenObserve, el siguiente paso consiste en alimentarlo con información. Al fin y al cabo, una plataforma de observabilidad no aporta ningún valor si no recibe datos sobre los que trabajar.
Cuando uno empieza con OpenObserve es habitual pensar que será el propio servidor quien “salga a buscar” los logs repartidos por la infraestructura. Sin embargo, el funcionamiento es justo el contrario: son los propios equipos quienes envían la información hacia OpenObserve mediante distintos mecanismos de ingesta.
En mi laboratorio he decidido utilizar OpenTelemetry Collector como punto central de toda la recopilación de datos. En lugar de que cada aplicación conozca OpenObserve y envíe directamente la información, todas ellas se comunican con el Collector, que actúa como intermediario recibiendo, procesando y reenviando los datos.
Esta arquitectura ofrece varias ventajas. Por un lado, desacopla las fuentes de información del sistema de almacenamiento, de manera que si en un futuro decidiera sustituir OpenObserve por otra plataforma, bastaría con modificar el exportador del Collector sin necesidad de reconfigurar todos los agentes. Por otro, permite transformar, enriquecer o filtrar la información antes incluso de que llegue a almacenarse.
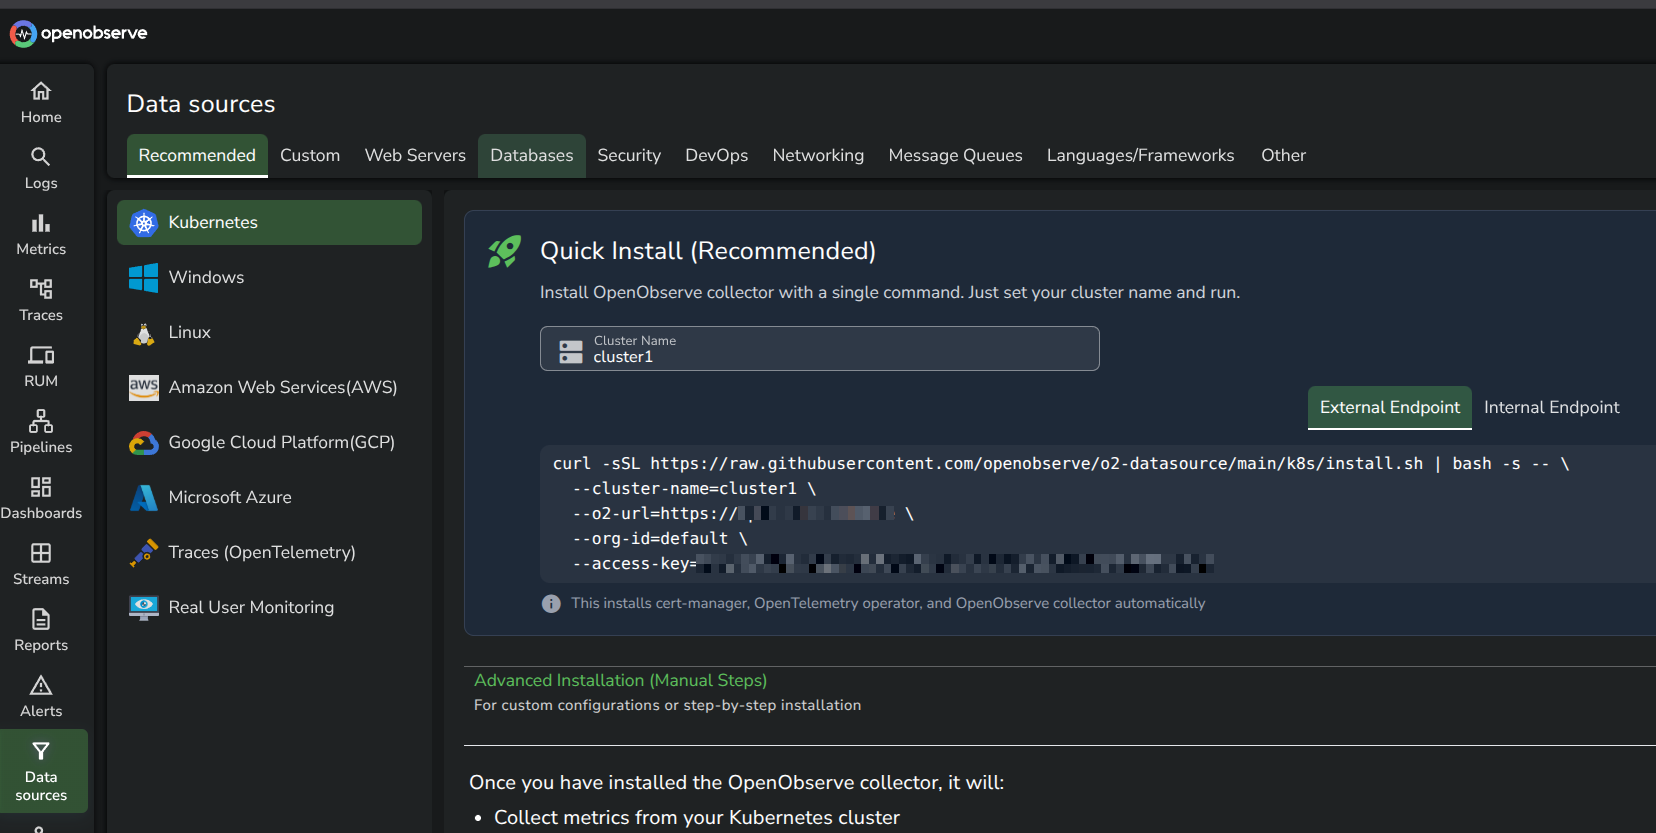
Podemos ver además como hay distintos apartados con distintos servicios y herramientas de los cuales se puede recoger información.
La API de OpenObserve
Toda la ingesta de datos se realiza a través de la API HTTP que proporciona OpenObserve.
Cada exportador únicamente necesita conocer tres elementos:
- La dirección del servidor.
- Las credenciales de autenticación.
- El stream donde se almacenarán los datos.
En mi caso la comunicación se realiza contra el endpoint https://openobserveURL.lan/api/default/
La autenticación se realiza mediante una cabecera Authorization utilizando autenticación Basic.
Además, es posible indicar el destino de los datos mediante la cabecera stream-name. Esto permite decidir en qué stream se almacenará cada tipo de información.
En mi laboratorio los eventos del sistema y los registros de Suricata se almacenan en streams diferentes, facilitando posteriormente las búsquedas, la creación de dashboards y la configuración de alertas específicas.
Con las siguientes imágenes de la interfaz web tal vez ayuden mejor a visualizar las ideas de las que se pretende desarrollar en esta entrada de hoy.
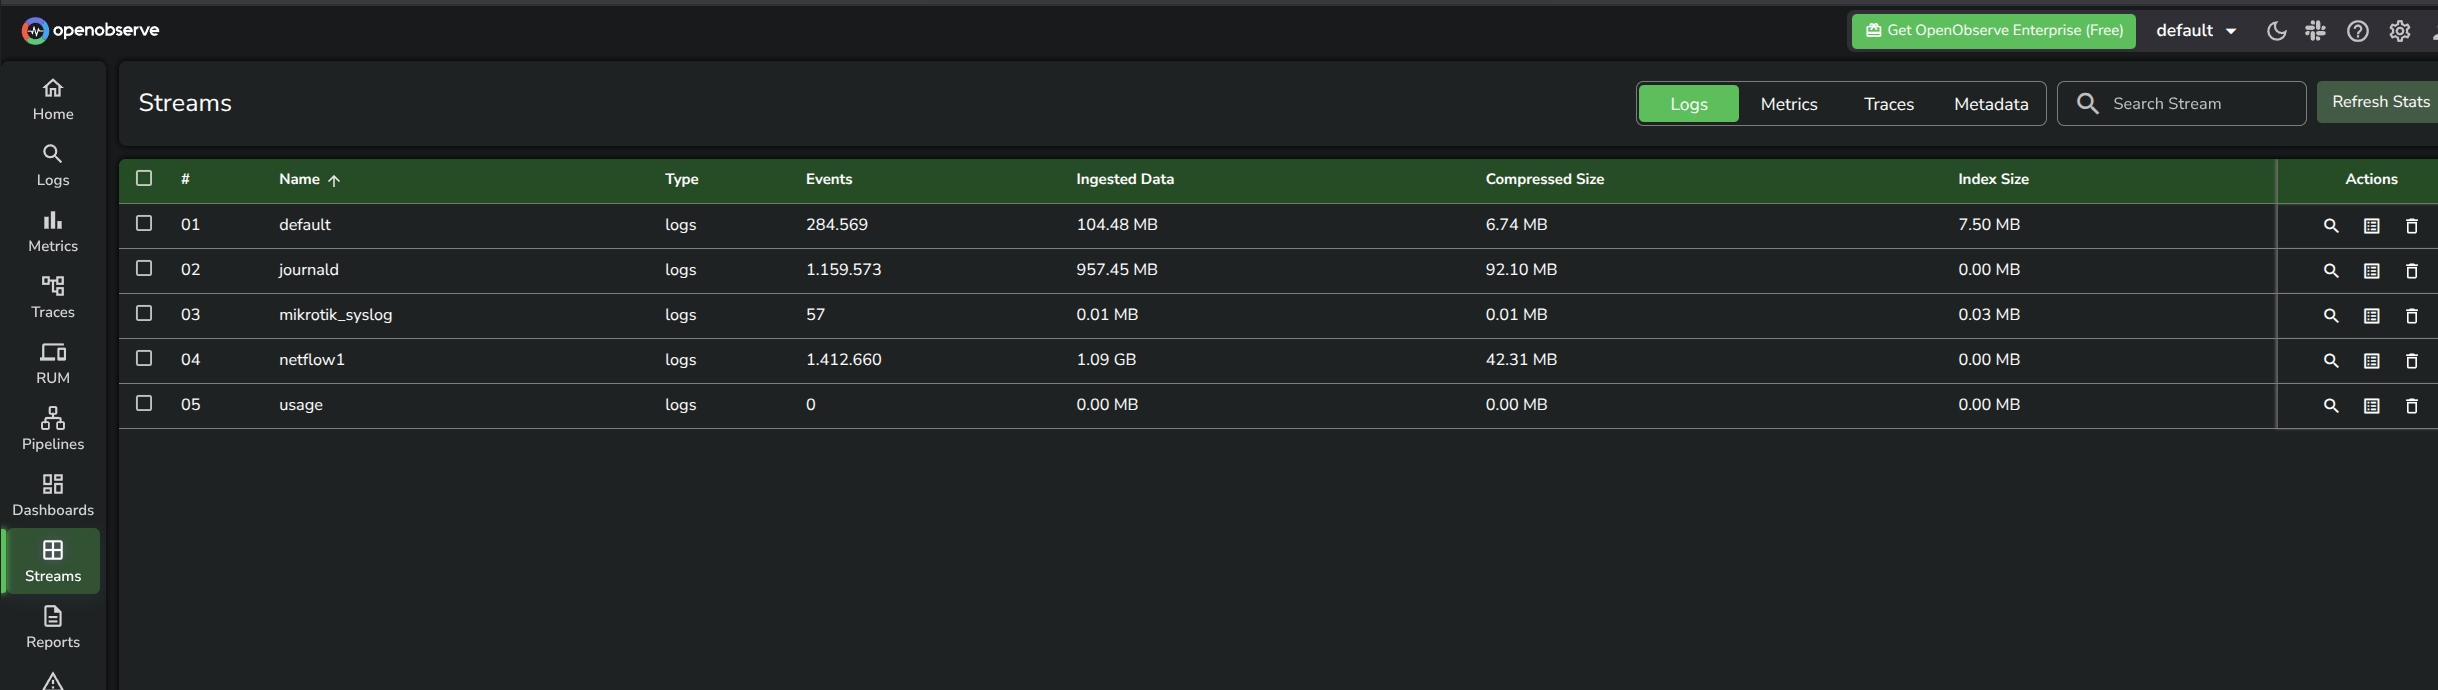
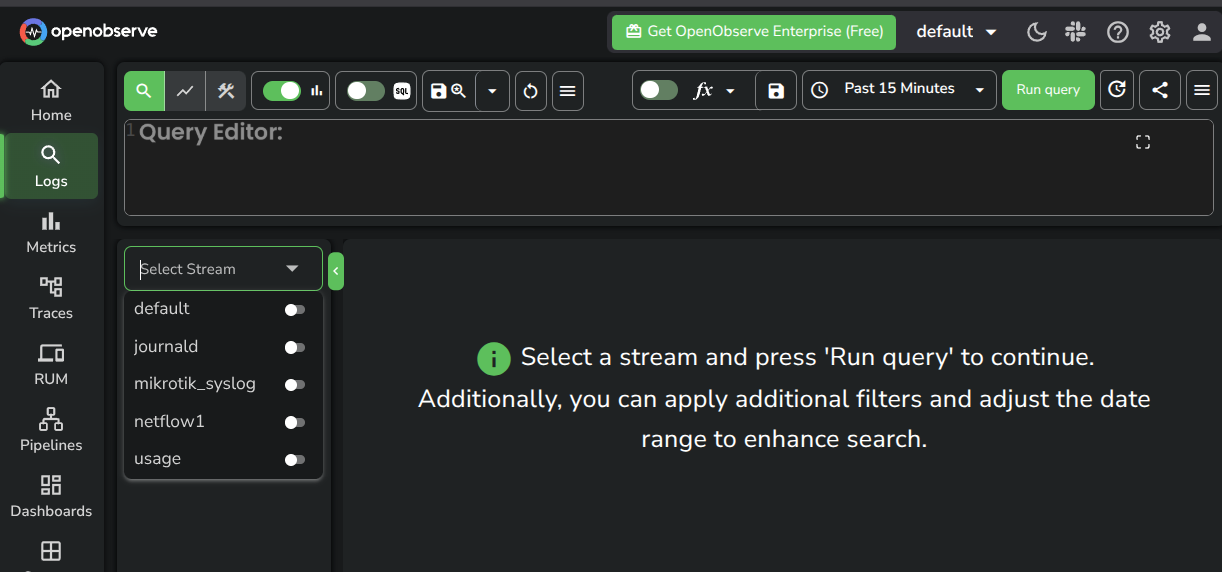
En esta segundo no aparece el stream suricata porque al no generarse logs, no se genera el stream en el apartado de consultar logs.
Arquitectura de la ingesta
Aunque OpenObserve soporta múltiples métodos de ingesta, toda la información de mi laboratorio sigue el mismo recorrido:
                ┌───────────────────────┐
                │  Sistemas origen      │
                │                       │
                │ • Journald            │
                │ • Logs (/var/log)     │
                │ • Suricata            │
                │ • Host Metrics        │
                └───────────┬───────────┘
                            │
                            ▼
              OpenTelemetry Collector
                            │
        ┌───────────────────┴───────────────────┐
        │                                       │
        |   Receivers → Processors → Exporters  |
        │                                       │
        └───────────────────┬───────────────────┘
                            │
                            ▼
                      OpenObserve
                            │
                            ▼
      Streams → Dashboards → Alertas → Consultas
OpenObserve únicamente almacena y explota la información.
Todo el trabajo relacionado con la recopilación, transformación y envío de datos queda centralizado en OpenTelemetry Collector.
Anatomía del fichero de configuración
Toda la configuración del Collector reside en un único fichero, en mi caso alojado en /etc/otel-config.yaml(ANEXO I):
Este fichero gira alrededor de cuatro bloques principales.
Una vez comprendida la función de cada uno de ellos, resulta mucho más sencillo interpretar cualquier configuración de OpenTelemetry.
Receivers
Los receivers representan las fuentes de información.
Su única función consiste en capturar datos desde distintos orígenes (Logs de systemd, otros ficheros de log, métricas…)
receivers:
  journald:
    directory: /var/log/journal
  filelog/std:
    include: [ /var/log/**log ]
  filelog/suricata:
    include: [ /var/log/suricata/fast.log ]
    start_at: end # para que lea desde los nuevos eventos

  hostmetrics:
    root_path: /
    collection_interval: 20s
    scrapers:
      cpu:
      disk:
      filesystem:
      load:
      memory:
      network:
      paging:
      processes:
Processors
Una vez recibida la información, esta pasa por uno o varios processors.
Los processors permiten:
- añadir información adicional;
- eliminar campos;
- transformar datos;
- convertir formatos;
- limitar el consumo de memoria;
- agrupar eventos antes del envío.
Básicamemte, preparan los datos antes de almacenarlos.
processors:
  resourcedetection/system:
    detectors: ["system"]
    system:
      hostname_sources: ["os"]

  transform/json_sensors:
    error_mode: ignore
    log_statements:
      - context: log
        statements:
          - set(attributes["_temp_json"], ParseJSON(body)) where IsMatch(body, "processor_fan")
          - set(attributes["cpu"], attributes["_temp_json"]["cpu"]) where IsMatch(body, "processor_fan")
          - set(attributes["processor_fan"], attributes["_temp_json"]["processor_fan"]) where IsMatch(body, "processor_fan")
          - set(attributes["ambient"], attributes["_temp_json"]["ambient"]) where IsMatch(body, "processor_fan")
          - set(attributes["core_0"], attributes["_temp_json"]["core_0"]) where IsMatch(body, "processor_fan")
          - set(attributes["core_1"], attributes["_temp_json"]["core_1"]) where IsMatch(body, "processor_fan")
          - delete_key(attributes, "_temp_json") where IsMatch(body, "processor_fan")
  memory_limiter:
    check_interval: 1s
    limit_percentage: 75
    spike_limit_percentage: 15
  batch:
    send_batch_size: 10000
    timeout: 10s
Transform
Quería registrar la temperatura sin necesidad de instalar todo un recolector de métricas, así que lo que hice fue generar un script que lanzara el comando sensors y guardara la salida en un fichero a modo de log.
Este “processors” parsea, chunkea e interpreta determinados registros JSON generados por este log.
Warning
Importante en este punto también añadir este fichero a logrotate para que no te esté generando un fichero infinito.
En lugar de almacenar el documento completo como texto plano en Openobserve, extrae automáticamente valores como:
- temperatura de CPU;
- velocidad del ventilador;
- temperatura ambiente;
- temperatura de cada núcleo.
De esta forma esos datos pasan a convertirse en campos independientes sobre los que posteriormente puedo realizar consultas o generar gráficos.
Memory Limiter
Protege al propio Collector frente a consumos excesivos de memoria.
Si el volumen de datos aumenta considerablemente, evita que el proceso termine siendo finalizado por el sistema operativo.
Batch
Agrupa múltiples eventos antes de enviarlos.
Con ello se reduce el número de peticiones HTTP realizadas hacia OpenObserve y mejora el rendimiento general de la ingesta.
Exporters
Los exporters son los encargados de enviar la información procesada hacia su destino, en este caso OpenObserve.
En este laboratorio todos los exportadores envían los datos mediante OTLP HTTP hacia OpenObserve.
exporters:
  otlphttp/openobserve:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: true
    headers:
      Authorization: "Nivel + contraseñacodificada"

  otlphttp/openobserve_journald:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: true
    headers:
      Authorization: "Nivel + contraseñacodificada"
      stream-name: journald

  otlphttp/openobserve_suricata:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: false
    headers:
      Authorization: "Nivel + contraseñacodificada"
      stream-name: suricata
Aunque todos apuntan al mismo servidor, he definido varios exportadores distintos para separar cada tipo de dato en un stream diferente.
Esto mantiene la información organizada desde el mismo momento en que llega a la plataforma.
Service
El bloque service es el encargado de unir todas las piezas anteriores.
Aquí se definen los llamados pipelines, que indican qué receiver utilizar, qué processors aplicar y qué exporter enviará finalmente los datos.
Es decir, el bloque service describe el recorrido completo que seguirá cada tipo de información.
service:
  extensions: [zpages]
  pipelines:
    metrics:
      receivers: [hostmetrics]
      processors: [resourcedetection/system, memory_limiter, batch]
      exporters: [otlphttp/openobserve]
    logs:
      receivers: [filelog/std]
      processors: [resourcedetection/system, transform/json_sensors, memory_limiter, batch]
      exporters: [otlphttp/openobserve]

    logs/journald:
      receivers: [journald]
      processors: [resourcedetection/system, memory_limiter, batch]
      exporters: [otlphttp/openobserve_journald]
Los pipelines
Una vez comprendidos los cuatro bloques anteriores, entender los pipelines resulta mucho más sencillo.
Cada pipeline no es más que una cadena formada por:
Receiver
      │
      ▼
Processor(s)
      │
      ▼
Exporter
Por ejemplo:
- Las métricas utilizan hostmetrics, pasan por varios procesadores y terminan almacenándose en OpenObserve.
- Los logs del sistema utilizan filelog.
- Los eventos de journald siguen otro pipeline independiente.
- Los registros de Suricata disponen de su propio flujo de procesamiento.
Esta modularidad es probablemente una de las características que más me ha gustado de OpenTelemetry Collector, ya que permite construir arquitecturas muy flexibles sin necesidad de duplicar configuraciones.
El servicio de OpenTelemetry
Para que el Collector permanezca funcionando de forma continua, lo he configurado como un servicio de systemd, /etc/systemd/system/otel-collector.service
De esta manera:
- se inicia automáticamente durante el arranque del servidor;
- se reinicia si el proceso falla;
- funciona de manera completamente transparente para el administrador.
[Unit]
Description=OpenTelemetry Collector
After=network.target network-online.target

[Service]
ExecStart=/usr/local/bin/otelcol-contrib --config /etc/otel-config.yaml
Restart=always
RestartSec=10
User=openobserve-agent
Group=openobserve-agent

[Install]
WantedBy=multi-user.target
Conclusiones
En este momento puedo decir que OpenTelemetry Collector se convierte en una parte imprescindible de Openobserve.
Mientras OpenObserve se encarga de almacenar, indexar y visualizar la información, el Collector controla qué datos llegan, cómo llegan y en qué formato lo hacen.
Comprender esta separación de responsabilidades facilita enormemente el diseño de una plataforma de observabilidad y hace que ampliar la infraestructura sea mucho más sencillo. Incorporar un nuevo servidor, un contenedor, un IDS o cualquier otra fuente de información suele reducirse, en la mayoría de los casos, a añadir un nuevo receiver o definir un nuevo pipeline.
En la siguiente entrada comenzaré a explotar toda esta información mediante consultas, dashboards y alertas, aprovechando todo el potencial que ofrece OpenObserve una vez que los datos ya están correctamente estructurados.
ANEXO I
Fichero de configuración
receivers:
  journald:
    directory: /var/log/journal
  filelog/std:
    include: [ /var/log/**log ]
  filelog/suricata:
    include: [ /var/log/suricata/fast.log ]
    start_at: end # para que lea desde los nuevos eventos

  hostmetrics:
    root_path: /
    collection_interval: 20s
    scrapers:
      cpu:
      disk:
      filesystem:
      load:
      memory:
      network:
      paging:
      processes:

processors:
  resourcedetection/system:
    detectors: ["system"]
    system:
      hostname_sources: ["os"]

  transform/json_sensors:
    error_mode: ignore
    log_statements:
      - context: log
        statements:
          - set(attributes["_temp_json"], ParseJSON(body)) where IsMatch(body, "processor_fan")
          - set(attributes["cpu"], attributes["_temp_json"]["cpu"]) where IsMatch(body, "processor_fan")
          - set(attributes["processor_fan"], attributes["_temp_json"]["processor_fan"]) where IsMatch(body, "processor_fan")
          - set(attributes["ambient"], attributes["_temp_json"]["ambient"]) where IsMatch(body, "processor_fan")
          - set(attributes["core_0"], attributes["_temp_json"]["core_0"]) where IsMatch(body, "processor_fan")
          - set(attributes["core_1"], attributes["_temp_json"]["core_1"]) where IsMatch(body, "processor_fan")
          - delete_key(attributes, "_temp_json") where IsMatch(body, "processor_fan")
  memory_limiter:
    check_interval: 1s
    limit_percentage: 75
    spike_limit_percentage: 15
  batch:
    send_batch_size: 10000
    timeout: 10s

extensions:
  zpages: {}

exporters:
  otlphttp/openobserve:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: true
    headers:
      Authorization: "Nivel + contraseñacodificada"

  otlphttp/openobserve_journald:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: true
    headers:
      Authorization: "Nivel + contraseñacodificada"
      stream-name: journald

  otlphttp/openobserve_suricata:
    endpoint: https://openobserveURL.lan/api/default/
    tls:
      insecure_skip_verify: false
    headers:
      Authorization: "Nivel + contraseñacodificada"
      stream-name: suricata

service:
  extensions: [zpages]
  pipelines:
    metrics:
      receivers: [hostmetrics]
      processors: [resourcedetection/system, memory_limiter, batch]
      exporters: [otlphttp/openobserve]
    logs:
      receivers: [filelog/std]
      processors: [resourcedetection/system, transform/json_sensors, memory_limiter, batch]
      exporters: [otlphttp/openobserve]

    logs/journald:
      receivers: [journald]
      processors: [resourcedetection/system, memory_limiter, batch]
      exporters: [otlphttp/openobserve_journald]